Concevoir le futur du vivant : comment l'IA et la conception de protéines dépassent la nature

Introduction à la révolution de la biologie computationnelle
Pendant des milliards d'années, le plan directeur de tous les êtres vivants sur Terre a été dicté par un seul processus évolutif implacable : la sélection naturelle. Les organismes se sont adaptés lentement à leur environnement, en mutant et en sélectionnant des protéines capables de maintenir la vie, de combattre les infections et de catalyser des réactions métaboliques. Aujourd'hui, cependant, ce paradigme est en train de changer radicalement. Grâce à la convergence de l'informatique avancée et de la biologie moléculaire, les scientifiques ne sont plus liés par les limites de ce que la nature a inventé par hasard.
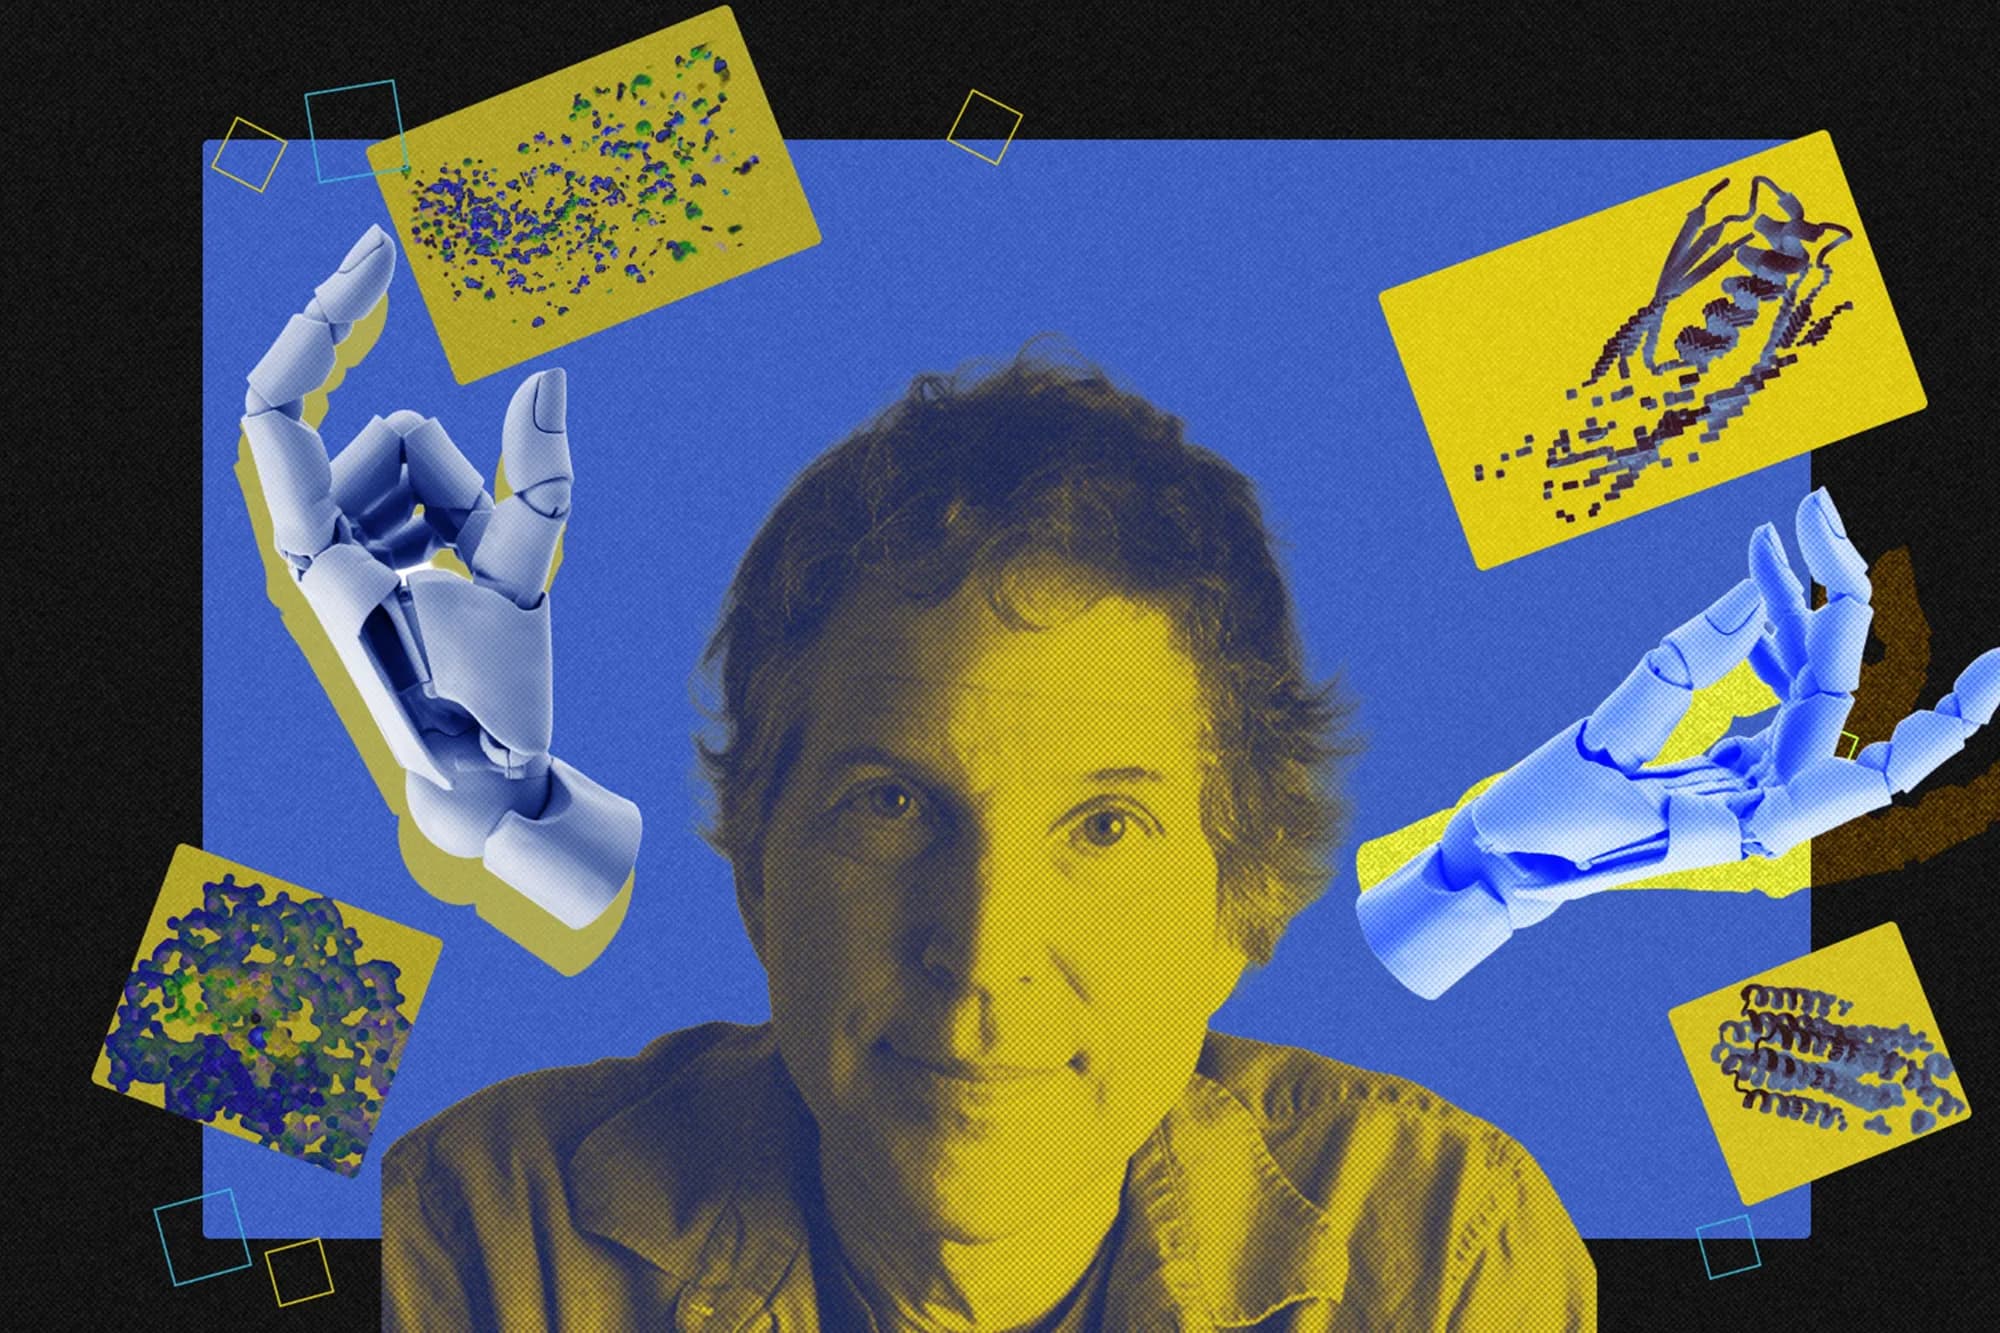
À l'avant-garde de ce changement monumental se trouve David Baker, dont le travail pionnier dans la conception computationnelle de protéines lui a récemment valu un prix Nobel. Lors de discussions récentes sur l'avenir de son domaine, Baker a souligné à quel point l'intelligence artificielle a décuplé notre capacité à concevoir des molécules sur mesure à partir de zéro. Ce développement n'est pas seulement un triomphe académique ; il représente une transition fondamentale de la biologie vers une discipline d'ingénierie, ouvrant la porte à des thérapies et à des matériaux conçus sur mesure qui n'ont jamais existé dans le monde naturel.
Décoder le plan directeur : l'essor de la conception de protéines de novo
Les protéines sont les moteurs de la biologie, exécutant presque toutes les tâches cellulaires imaginables. Leurs fonctions complexes sont dictées par leurs structures tridimensionnelles, qui sont elles-mêmes déterminées par des séquences linéaires d'acides aminés. Pendant des décennies, la biochimie s'est concentrée sur l'analyse et la modification de protéines naturelles. Cependant, le véritable graal pour les chercheurs était la conception de novo, c'est-à-dire la construction de protéines entièrement nouvelles dotées de fonctions spécifiques et souhaitées, directement à partir de modèles computationnels.
Pour y parvenir, il a fallu résoudre un casse-tête computationnel astronomique. Le nombre de combinaisons d'acides aminés possibles pour une protéine de taille modeste est vertigineux, dépassant de loin le nombre d'atomes dans l'univers observable. Les premières tentatives computationnelles reposaient largement sur des approximations physiques simplifiées et un échantillonnage par force brute, ce qui a donné des succès limités. La percée s'est produite lorsque les chercheurs ont commencé à exploiter des algorithmes capables de prédire avec précision comment les chaînes d'acides aminés se replient en formes tridimensionnelles stables, leur permettant de remonter d'une fonction souhaitée à une structure moléculaire conçue.
Le tournant de l'apprentissage automatique
L'introduction d'architectures d'apprentissage profond a transformé la biologie structurale presque du jour au lendemain. Les modèles d'apprentissage automatique formés sur de vastes bases de données de structures protéiques connues ont appris la grammaire cachée du repliement moléculaire avec une précision sans précédent. Au lieu de s'appuyer uniquement sur des simulations physiques rigides, les systèmes d'IA modernes peuvent générer des squelettes et des séquences de protéines inéditspresque instantanément.
Cette intégration de l'IA générative dans la biochimie rappelle les modèles de langage qui écrivent du texte ou génèrent des images. En traitant les acides aminés comme un vocabulaire biologique, les algorithmes peuvent composer des phrases moléculaires entièrement fonctionnelles. Ces outils permettent aux scientifiques de spécifier des contraintes — telles que se lier étroitement à une cible virale spécifique ou catalyser une réaction chimique délicate — et de demander au logiciel de produire une conception de protéine sur mesure, prête pour la synthèse et les tests en laboratoire.
Pourquoi cela compte pour la médecine et l'industrie
Les implications pratiques de la programmation de la biologie avec du code sont profondes. Dans le domaine de la médecine, les protéines conçues sur mesure peuvent agir comme des thérapies de précision, capables de neutraliser des agents pathogènes résistants aux médicaments, de cibler des cellules cancéreuses avec un minimum d'effets secondaires ou de servir de vaccins hyperstables. Contrairement aux produits biologiques traditionnels récoltés à partir de cellules vivantes, ces molécules synthétiques peuvent être optimisées pour leur durabilité, leur facilité de fabrication et leurs profils pharmacologiques exacts.
Au-delà de la santé, les applications industrielles sont vastes. Des enzymes modifiées pourraient être déployées pour décomposer des polluants environnementaux persistants comme les plastiques, capturer efficacement les émissions de carbone ou synthétiser des produits chimiques verts et des matériaux durables. En sortant de la bibliothèque de l'évolution naturelle, l'humanité se dote d'une boîte à outils moléculaire polyvalente conçue spécifiquement pour relever les défis écologiques et industriels modernes.
La perspective du développeur : la biologie comme du code
Pour les ingénieurs logiciels et les data scientists, l'ère actuelle de la biotechnologie semble frappante de familiarité. La recherche biologique est de plus en plus devenue une science de l'information. L'ADN, l'ARN et les séquences d'acides aminés sont des chaînes de données numériques ; les algorithmes de repliement sont des pipelines computationnels ; et les laboratoires s'orientent vers des installations de tests automatisées à haut débit qui fonctionnent presque comme des serveurs d'intégration continue.
Cette intersection de la technologie et de la biologie crée de nouveaux paradigmes passionnants pour les développeurs. Les modèles open source, les plateformes de conception biologique pilotées par API et les accélérateurs matériels spécialisés deviennent des outils standard dans les startups biotechnologiques. L'état d'esprit du développeur — axé sur la modularité, l'optimisation, l'abstraction et l'itération rapide — insuffle une nouvelle vague d'innovation où l'écriture de logiciels se traduit directement par la fabrication de matière physique.
Risques, biosécurité et questions ouvertes
Comme pour toute technologie transformatrice, la capacité à concevoir une nouvelle biologie comporte des risques importants. Les mêmes outils computationnels capables de concevoir des thérapies salvatrices pourraient théoriquement être mal utilisés pour synthétiser des toxines ou des agents pathogènes dangereux. Garantir une gestion responsable des logiciels biologiques génératifs est l'un des défis les plus pressants auxquels sont confrontées les communautés scientifiques et réglementaires aujourd'hui.
Les questions relatives à la propriété intellectuelle, à l'impact environnemental et à la gouvernance de la recherche à double usage doivent être abordées de manière proactive. À mesure que les modèles de conception de protéines open source deviennent plus accessibles, il sera crucial de trouver le juste équilibre entre la collaboration scientifique ouverte et des garanties de biosécurité robustes pour prévenir les dommages non intentionnels tout en continuant de récolter les immenses avantages de la biologie synthétique.
La route à suivre
Nous ne faisons qu'effleurer la surface de ce qui est possible lorsque l'ingéniosité humaine rencontre la biologie computationnelle. À mesure que les algorithmes deviennent plus puissants et que notre compréhension de la machinerie cellulaire s'approfondit, la frontière entre les systèmes vivants et la technologie modifiée continuera de s'estomper. La transition de la découverte de la nature à sa réécriture à partir de zéro est bien engagée, promettant un avenir défini par des solutions moléculaires sur mesure pour nos problèmes les plus complexes.
Source: wired.com